
Tag: petabyte-scale datasets
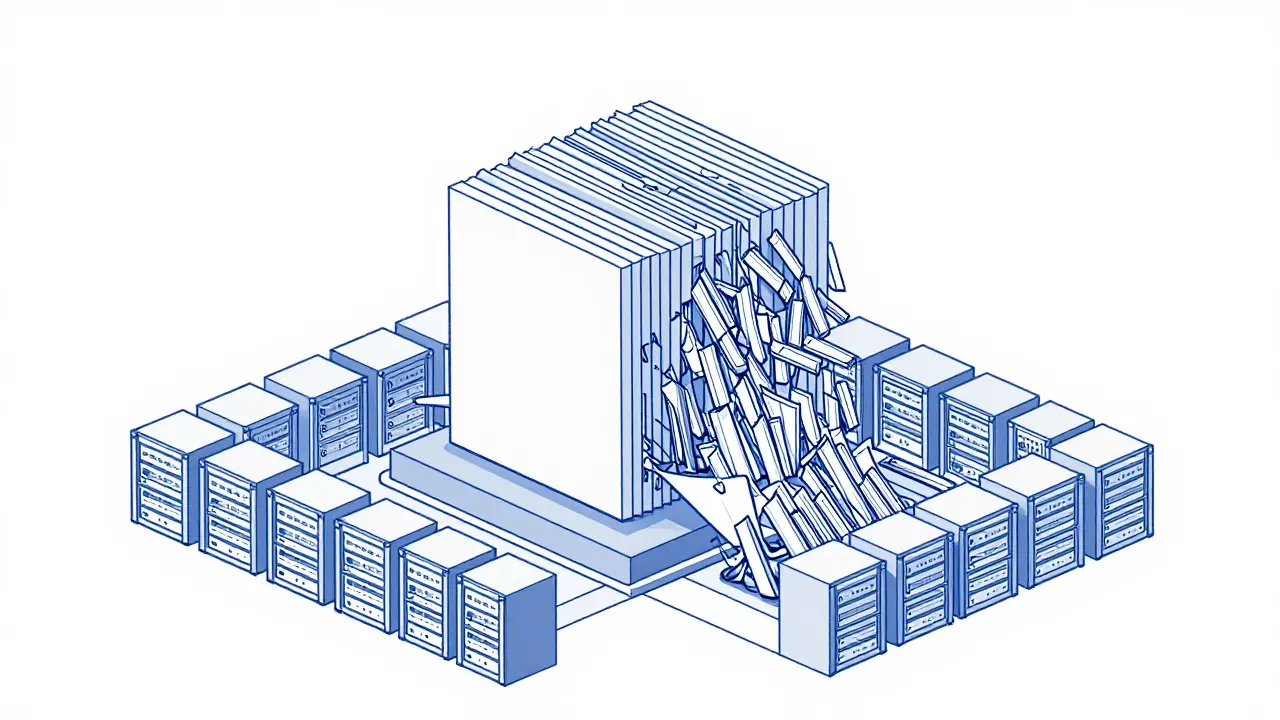
Learn how to optimize sharding and data loading for petabyte-scale LLM datasets. Discover tiered storage strategies, sharded data parallelism, and tips to prevent GPU idling in large-scale training pipelines.
Categories
 Artificial Intelligence
Archives
Recent-posts
Security Vulnerabilities and Risk Management in AI-Generated Code: A 2026 Guide
Jul, 11 2026
Streaming Responses in LLM APIs: Architecture and User Experience
Oct, 30 2026
Few-Shot Fine-Tuning of Large Language Models: When Data Is Scarce
Feb, 9 2026
Colorado SB24-205 Guide: AI Impact Assessments and Risk Management
Apr, 16 2026
Bias in Large Language Models: Sources, Measurement, and Mitigation
Mar, 18 2026